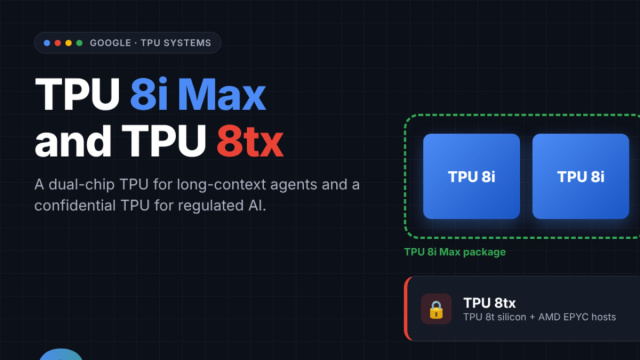
Google espande il proprio portafoglio di acceleratori per l'intelligenza artificiale con due sistemi specializzati: i Google TPU 8tx e TPU 8i Max. Questo lancio si inserisce nella strategia dei grandi cloud provider, volta a ridurre la dipendenza da chip di terze parti, in particolare da Nvidia. L'azienda sta segmentando l'hardware AI in base a specifici casi d'uso, dalla sicurezza dei dati alla gestione di finestre di contesto sempre più ampie, evidenziando una chiara direzione verso la specializzazione dell'hardware AI.
TPU 8tx: sicurezza hardware per dati e modelli
Il Google TPU 8tx è stato concepito per training e inferenza confidenziali. È ideale per imprese regolamentate, pubbliche amministrazioni e organizzazioni che necessitano di utilizzare modelli proprietari o agenti autonomi senza esporre dati sensibili e pesi dei modelli durante l'elaborazione. Questo approccio è cruciale, poiché molti sistemi cifrano i dati a riposo e in transito, ma li rendono leggibili in memoria durante il processo.
Il TPU 8tx integra protezioni direttamente a livello hardware ed è abbinato a host AMD EPYC di quinta generazione. Il sistema sfrutta inoltre una rete a bassa latenza per ottimizzare ragionamento, personalizzazione e addestramento leggero.
Ciò consente alle aziende di affinare modelli, distillarli in versioni più piccole o addestrare agenti senza dover spostare dataset riservati tra cluster separati, garantendo così un cloud più sicuro.
TPU 8i Max: più memoria per contesti estesi
Il secondo componente, il TPU 8i Max, è progettato per superare il cosiddetto memory wall, ovvero il collo di bottiglia che si verifica quando la quantità di dati da mantenere disponibili supera la capacità o la larghezza di banda della memoria. Google ha combinato due chip TPU 8i in un unico package, raddoppiando capacità di calcolo, SRAM e banda HBM rispetto al TPU 8i. L'obiettivo è supportare carichi di lavoro in cui più agenti AI analizzano basi di codice, documenti estesi o video, mantenendo un contesto molto ampio durante le interrogazioni.
Questa evoluzione conferma che la competizione nell'AI non si limita più al numero di operazioni al secondo. Per i modelli agentici, fattori come latenza, memoria, rete, software di orchestrazione e densità per rack sono diventati fondamentali. L'ottava generazione di TPU è descritta come una famiglia articolata: TPU 8t per il training, TPU 8i per il reasoning a bassa latenza, TPU 8tx per il confidential computing e TPU 8i Max per i grandi contesti, offrendo soluzioni potenti e mirate.
La corsa agli acceleratori proprietari
Il lancio di questi nuovi chip AI Google TPU avviene in un momento in cui hyperscaler e laboratori AI, tra cui Microsoft, Amazon, OpenAI e Anthropic, stanno intensificando gli investimenti in semiconduttori dedicati, sottolineando l'importanza strategica di questa tecnologia.