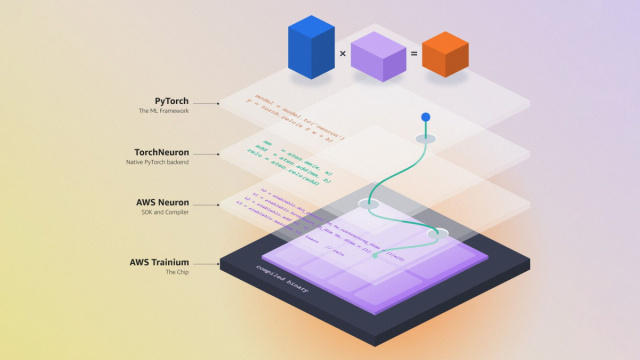
Con TorchNeuron, Amazon Web Services (AWS) mira a spostare la competizione nel campo dell'intelligenza artificiale dal solo terreno dei chip a quello, più decisivo, del software. Questo strumento consente agli sviluppatori che operano con PyTorch di eseguire i modelli sui chip AWS Trainium con modifiche minime alla configurazione, senza la necessità di riscrivere il codice applicativo. La promessa è sia tecnica che strategica: ridurre l'attrito che finora ha reso Nvidia, grazie all'integrazione tra GPU, CUDA e framework di sviluppo, la scelta quasi naturale per molti carichi di lavoro AI.
Il vantaggio software di Nvidia nel mirino di TorchNeuron
L'obiettivo di AWS non è soltanto offrire un'alternativa hardware potenzialmente più economica, ma indebolire il vantaggio accumulato da Nvidia nel livello di astrazione utilizzato quotidianamente dai team di intelligenza artificiale. PyTorch è uno degli ambienti più diffusi per l'addestramento e l'esecuzione di modelli, e negli anni l'ecosistema CUDA ha reso l'esperienza su GPU Nvidia particolarmente fluida. TorchNeuron cerca di replicare questa semplicità sui chip Trainium, trasformando la compatibilità software in una leva competitiva fondamentale per AWS.
La tesi di Amazon è chiara: se il passaggio a un chip alternativo richiede settimane di porting, test e validazione, il costo reale non si limita al prezzo dell'hardware, ma include significativamente il tempo degli ingegneri.
Ridurre questa barriera significa rendere più plausibile una scelta multi-chip, soprattutto per startup e imprese che cercano margini migliori sui workload di training e inferenza.
La visione di Amazon: meno riscritture, maggiore integrazione cloud
Nell'annuncio ufficiale, Amazon descrive TorchNeuron come un backend PyTorch nativo per Trainium, destinato al rilascio open source con licenza Apache 2.0 in occasione della PyTorch Conference North America del 20 ottobre 2026. Il messaggio è pensato per gli sviluppatori: il codice PyTorch esistente può essere eseguito su Trainium con una semplice modifica di configurazione, mantenendo la compatibilità con strumenti già noti nell'ecosistema, inclusi Hugging Face, TorchTitan e vLLM.
Amazon insiste anche sul valore operativo dell'integrazione verticale con la propria infrastruttura AWS. I chip Trainium vengono proposti come piattaforma unica per training e inference, una scelta che può aiutare a riutilizzare le capacità di calcolo in modo più flessibile. Il tema è rilevante perché molte aziende non valutano solo il costo per token o per ora di compute, ma l'intera catena: scalabilità, rete, storage, orchestrazione, sicurezza e disponibilità dei servizi cloud già usati in produzione.
PyTorch più agnostico: apertura o nuova complessità?
L'aspetto più interessante è la volontà di AWS di contribuire con modifiche upstream a PyTorch per renderlo meno legato a specifiche architetture hardware. In teoria, un framework più hardware-agnostic aumenta la libertà degli sviluppatori, offrendo maggiore flessibilità nella scelta.