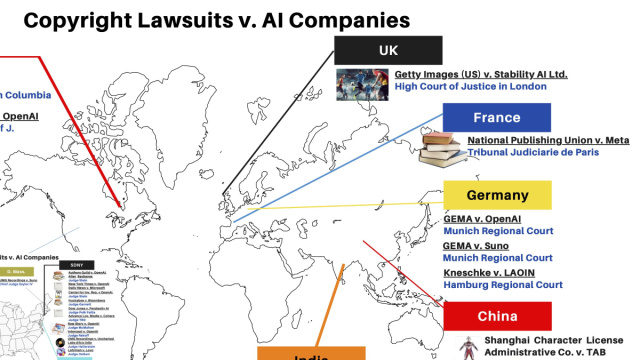
La recente azione legale del New York Times contro Brave intensifica il dibattito sullo scraping AI, intensificando il confronto tra editori, browser e piattaforme AI. Il gruppo editoriale accusa Brave di aver raccolto contenuti protetti da copyright e di averli distribuiti a clienti AI, tra cui Anthropic, Perplexity, Mistral, xAI e Cohere. La questione, oltre l'addestramento dei modelli, riguarda indici, riepiloghi e flussi informativi commerciali basati su contenuti giornalistici.
Le contestazioni del New York Times
La causa, depositata presso il tribunale federale di Manhattan, descrive Brave come un intermediario che avrebbe trasformato articoli protetti in una risorsa vendibile per aziende AI.
Altri editori, inclusi Daily News, Chicago Tribune e Orlando Sentinel, hanno avviato azioni legali simili. La disputa verte sull'idea che un browser e motore di ricerca possa superare l'indicizzazione, divenendo fornitore di contenuti sostitutivi delle testate originali.
Il caso è rilevante poiché Brave, nato per la privacy e il blocco degli annunci, opera oggi anche nella ricerca e nelle risposte generate. Le contestazioni includono una funzione che aggirerebbe i paywall e la pratica di bloccare la pubblicità dei publisher, vendendo al contempo propri spazi o servizi. Brave non ha fornito un commento immediato.
Il contesto legale: News Corp e il fair use
La controversia si inserisce in un quadro già teso.
Nel luglio 2026, una causa di News Corp contro Brave aveva accusato il browser di distribuire e vendere articoli del Wall Street Journal e del New York Post ad aziende AI. In quel procedimento, Brave sosteneva che l'indicizzazione, gli snippet e i riepiloghi rientrassero nel fair use, la dottrina statunitense che permette usi non autorizzati di opere protette in specifiche circostanze. News Corp, invece, parlava di scraping non autorizzato e di un danno diretto ai mercati delle licenze.
Il punto critico è la differenza tra motore di ricerca e infrastruttura dati per l’AI. Un motore classico rimanda alle fonti; un sistema di risposte o dataset può ridurre l’incentivo a visitare il sito originale. È qui che lo scraping AI diventa un tema industriale: non solo copia tecnica, ma redistribuzione economica del valore prodotto dal giornalismo.